为什么选择离线语音合成
在线 TTS 把文本发到云端才能开口;Lovo 反过来——模型住在你的机器上,随叫随到。
隐私与数据安全
在线 TTS 需要把文本发到云端,医疗、金融、企业内部文档、未公开内容就不太适合上传。离线 TTS 全程本地推理,文本不出设备,更适合敏感场景。
ZERO CLOUD UPLOAD成本可控
云端 TTS 多按字符、时长或调用次数计费,批量配音、长期高频使用时成本会累积。离线 TTS 模型一次性部署后,后续使用基本没有持续调用费。
ONE-TIME DEPLOY可集成、可自动化
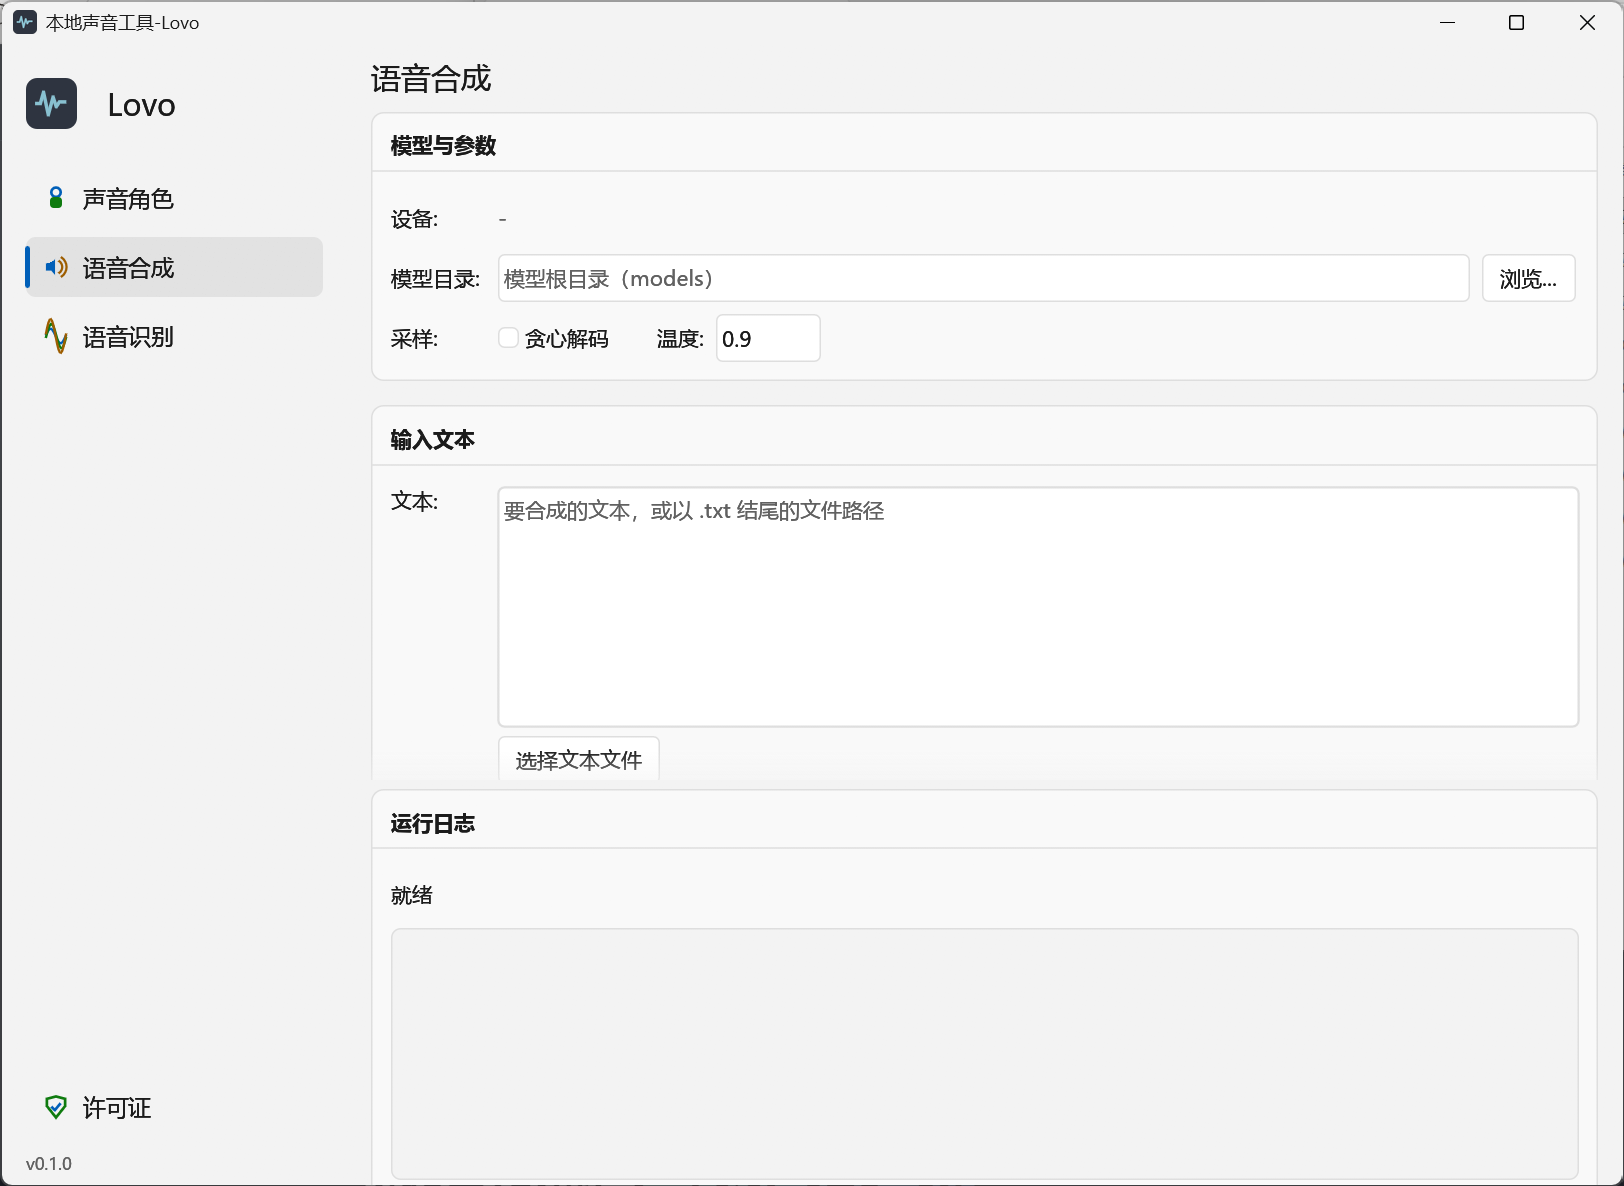
提供 CLI、HTTP API、桌面 UI,方便接入视频配音、批量生成、工作流自动化。比如批量生成旁白、为 ComfyUI 工作流提供音频输出,或做成内部配音服务。
CLI · API · GUI| 在线 TTS 服务 | Lovo(离线) | |
|---|---|---|
| 数据流向 | 文本上传云端,依赖供应商合规 | 文本与音频全程本地,不出设备 |
| 计费方式 | 按字符 / 时长 / 调用次数持续计费 | 一次部署,无限次调用零费用 |
| 集成方式 | 网络 SDK,受网络与限流约束 | CLI / 本地 HTTP API / 桌面 UI,进程内零延迟 |
| 断网可用 | 依赖网络连通性 | 完全可用,内网/隔离环境同样部署 |
主要功能特性
一个工具箱覆盖从"念稿子"到"克隆你的声音"再到"开放成服务"的完整链路。
声音克隆
一段参考音频提取声纹,驱动任意新文本;支持 ICL 参考文本与 x-vector 两种模式。
clone --reference9 个预设音色
CustomVoice 内置男女声与中英韩日风格:vivian、ryan、serena、sohee……一行参数切换。
--speaker vivian音色设计
VoiceDesign 模型用一句话文字描述,即生成全新的目标音色,无需任何参考音频;也可用 CLI 的 design 子命令驱动。
design --instruct多语言
中文、英文多语言输出,并提供日韩特色说话人(sohee / ono_anna),适配出海内容与多语种旁白需求。
--language长文本自动分段
超过 max-chars 的文本智能切分逐段合成再拼接,小说级长文、整章旁白直接喂入。
--max-chars 200设备自动选择
单一二进制,运行时优先 CUDA、不可用自动回退 CPU,无需区分构建版本。
CUDA → CPUOpenAI 兼容 API
POST /v1/audio/speech 请求体与官方一致,现有集成改个 base_url 即可指向本地。
:8000/v1/audio/speech采样与输出可控
贪心 / temperature 采样调节,WAV 输出;API 支持 8–96 kHz 采样率重采样。
--greedy / --temperature语音识别 (ASR)
Qwen3-ASR 将音频转写为文本,自动检测语言,也可强制指定语言与自定义最大 token。
asr --audio轻量部署
Rust 单二进制,无需安装 Python 环境;最低 8GB 显存 NVIDIA 显卡(CUDA)即可流畅运行,CPU 模式同样支持。
8GB VRAM · CPU18 秒看懂 Lovo
产品速览:本地推理、声音克隆、音色设计与桌面端一键出声。
时长 18 秒 · 含背景音乐 · 各项能力详见上方版块介绍
给 AI 助手的语音技能包
Lovo-skill 把 voice-cli 封装成技能包:在 Doubao 等 AI 助手的对话里,一句话就能触发语音合成、声音克隆、音色设计与语音识别,文本全程不出设备。
voice-cli(AI 助手可调用)
  ├─ synth   语音合成   --model-path <TTS> --text ... --speaker vivian
  ├─ clone   声音克隆   --reference ref.wav --text ... [--ref-text ref.txt]
  ├─ design  音色设计   --instruct "年轻女性,甜美温柔" --text ...
  └─ asr     语音识别   --audio input.wav [--language chinese]

全局:--model-path 必填;--max-chars 分段(默认 200)
许可:启动先校验 license.dat,未授权不执行
输出:合成/克隆/设计 WAV(24kHz),识别 TXT
用法示意 —— 对 AI 助手说"用 vivian 的声音朗读这段文案",助手即调用 synth,返回 output.wav。
bin/       voice-cli.exe · license.dat
models/    Qwen3-TTS-12Hz-1.7B-{Base,CustomVoice,VoiceDesign}
           Qwen3-ASR-<size>(含 tokenizer.json)
voices/    <voice-name>/voice-ref.wav + voice-ref.txt
9 个预设音色(CustomVoice)—— vivian、ryan、dylan、aiden、serena、eric、uncle_fu、sohee(韩)、ono_anna(日)。